Bảo vệ đồ án tốt nghiệp KMA PHÁT TRIỂN ỨNG DỤNG PHIÊN DỊCH VÀ TẠO PHỤ ĐỀ SONG NGỮ THỜI GIAN THỰC CHO VIDEO/AUDIO SỬ DỤNG MACHINE LEARNING
1 / 13
Đồ án tốt nghiệp · Ứng dụng phần mềm tích hợp Machine Learning

Phát triển ứng dụng phiên dịch và tạo phụ đề song ngữ thời gian thực cho video/audio

Trọng tâm của đồ án là xây dựng một hệ thống end-to-end hoàn chỉnh: từ ingest media, orchestration backend, pipeline AI, artifact tiến dần cho đến player subtitle song ngữ trên mobile.
Input Local media · YouTube URL
Core output chunks → translated_batches → final.json
Positioning Progressive asynchronous subtitle generation
Runtime focus System orchestration + ML integration
User-facing proof Processing UI · Player · Lookup / Explain
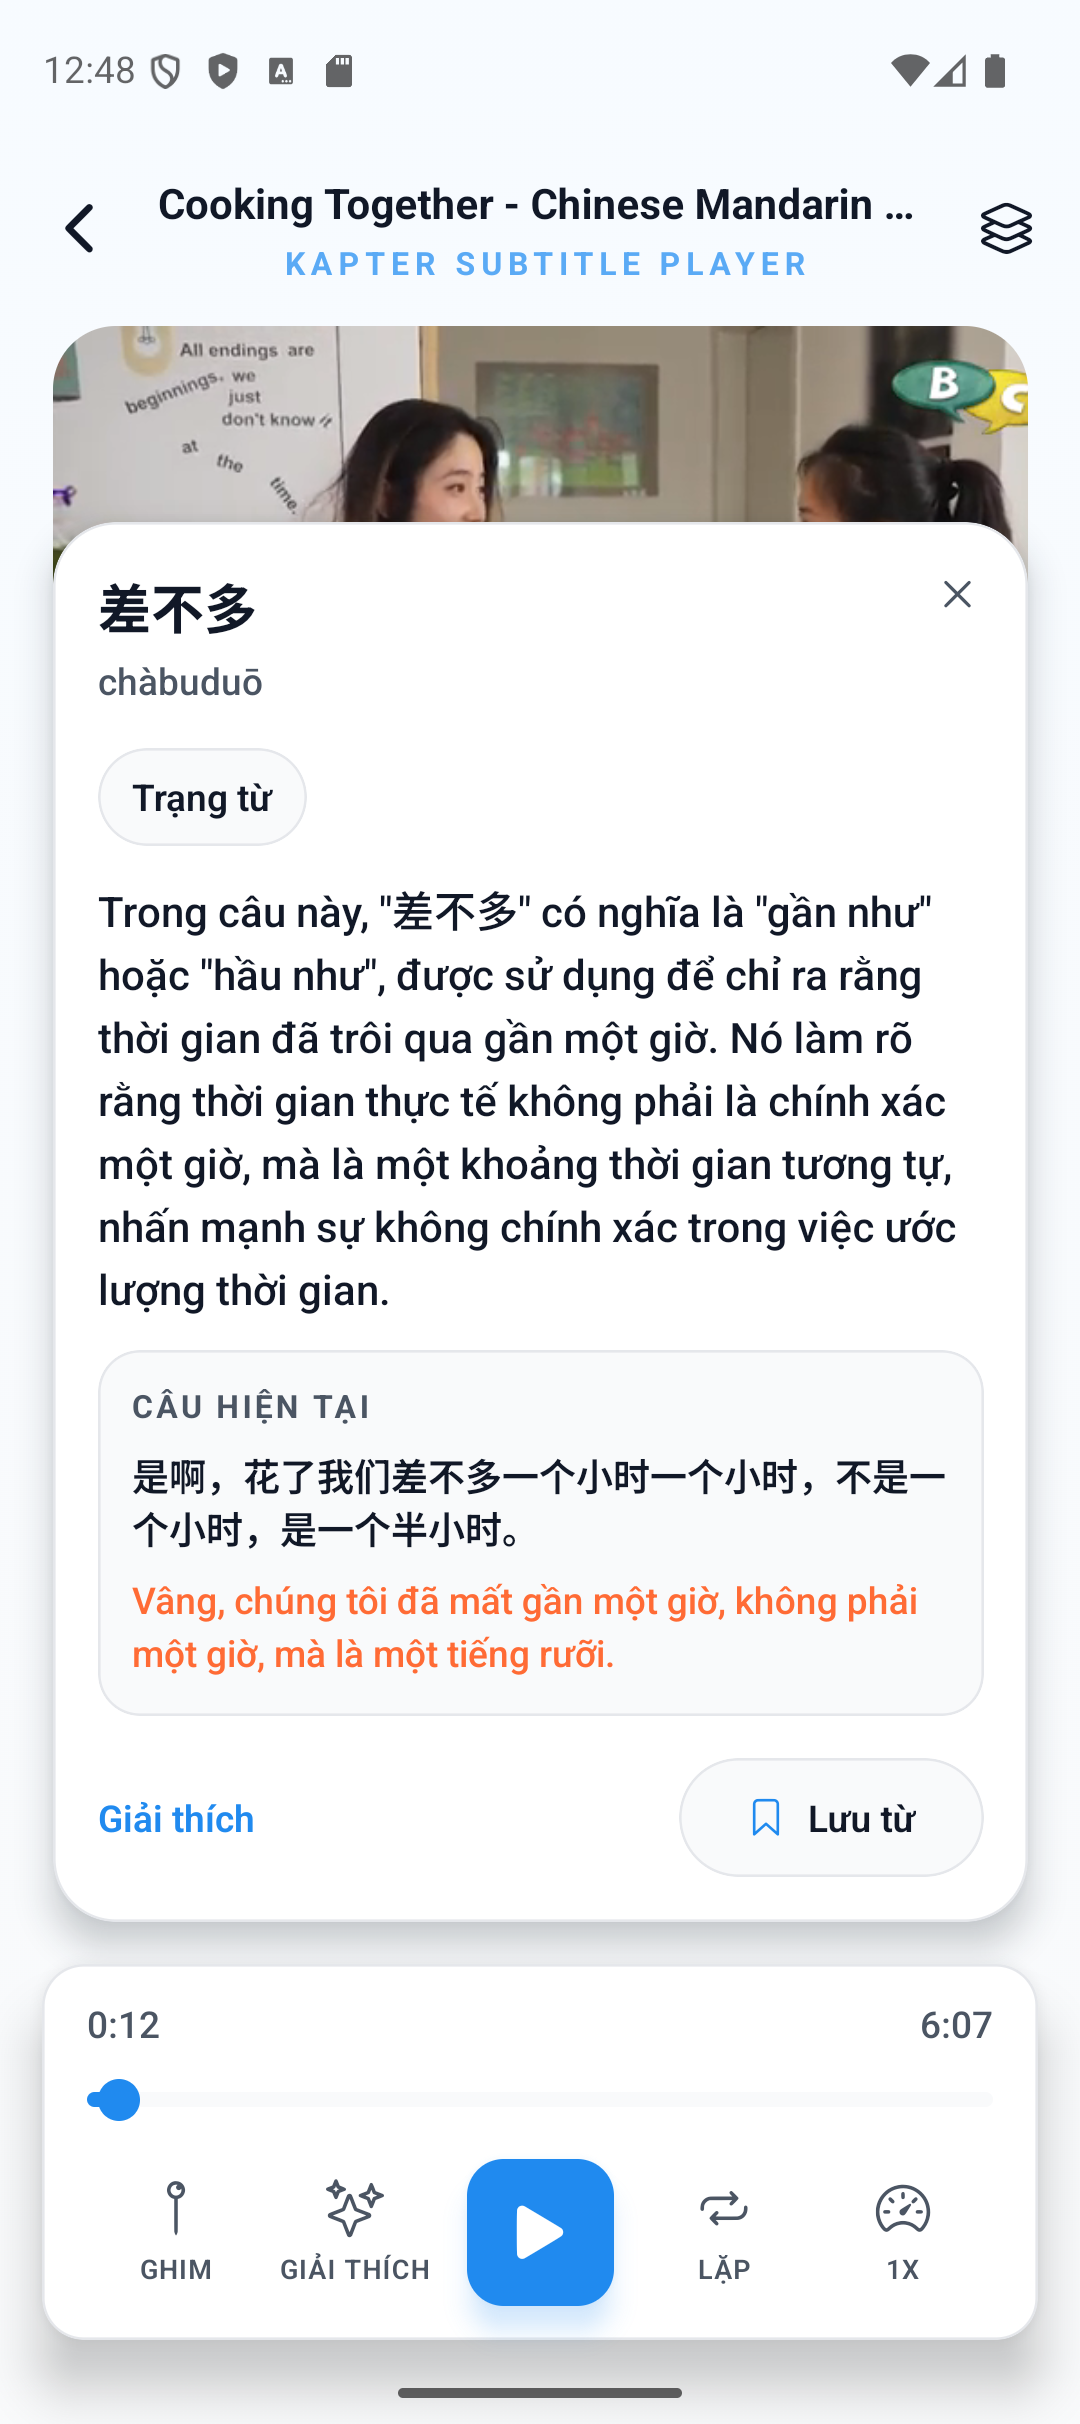
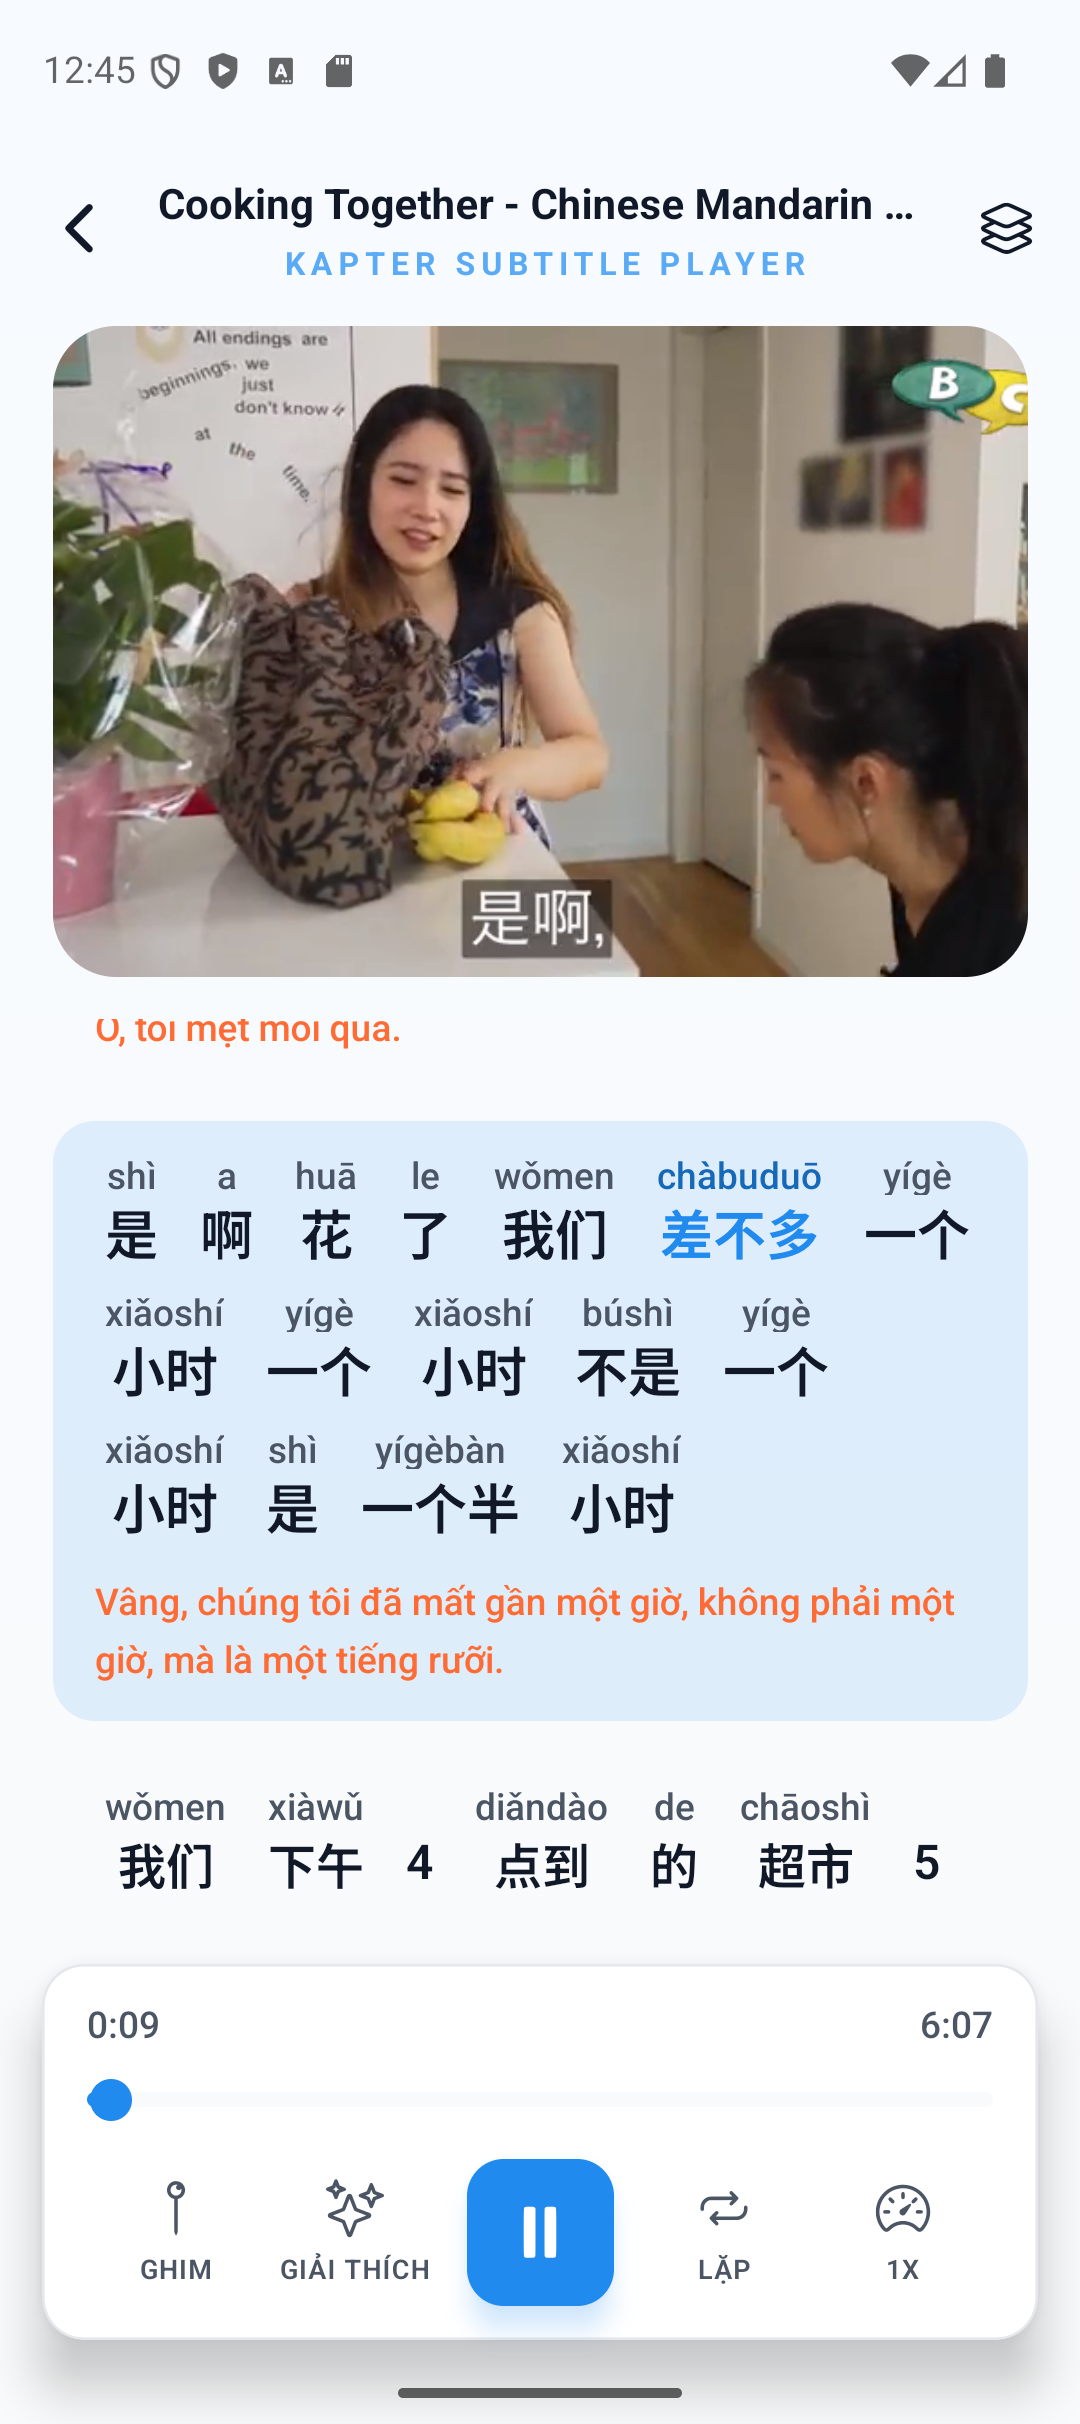
Màn hình player subtitle song ngữ
Player output Phụ đề song ngữ theo từng câu
Evidence path chunks → translated_batches → final.json
Bài toán

Từ nhu cầu thực tế đến mục tiêu hệ thống

01

Pipeline thủ công tốn thời gian

Transcript, dịch, căn thời gian và đóng gói subtitle thường phải đi qua nhiều bước rời rạc.

02

Người dùng phải chờ quá lâu

Nếu chỉ sinh output cuối cùng, người dùng không thấy được giá trị trong suốt quá trình xử lý.

03

Khó đưa ML vào sản phẩm thực tế

Bài toán không chỉ là nhận dạng và dịch, mà còn là queue, artifact, trạng thái bền và trải nghiệm người dùng.

Media input
→
Subtitle pipeline
→
Output tiến dần
→
Player song ngữ
Phạm vi

Hệ thống hiện tại gồm những gì

Trong phạm vi đồ án

  • Mobile app cho upload, processing, player, lookup và Explain
  • Backend API + backend worker cho auth, quota, validation và orchestration
  • AI Engine chạy queue subtitle pipeline với ASR, NMT và artifact export
  • Dashboard/admin và client-web cho vận hành, account và billing handoff

Ngoài phạm vi đồ án

  • Huấn luyện hoặc fine-tuning mô hình mới
  • Live simultaneous interpreting theo nghĩa tuyệt đối
  • Hạ tầng production HA hoặc multi-region scale
  • Đánh giá translation quality tự động quy mô lớn
Kiến trúc tổng thể

Bản đồ runtime của toàn bộ hệ thống

User-facing surfaces
Mobile App
Client-web
Dashboard
→
Entry + orchestration
Backend API
Socket mirror
Auth · quota · media APIs
→
Async processing path
BullMQ transcription
Backend Worker
BullMQ ai-processing
AI Engine
⇄
Persistent infrastructure
PostgreSQL
Redis / Pub-Sub
MinIO raw + processed
Tách lớp rõ ràng Client không chạm trực tiếp AI Engine hay hạ tầng nội bộ.
Queue-driven runtime Media nặng được xử lý bất đồng bộ, không chặn HTTP request path.
State bền + realtime Status lưu trong database, socket chỉ là kênh đồng bộ tiến dần.
End-to-end flow

Từ input media đến subtitle trên player

Local upload
Mobile xin presigned URL
↓
Upload trực tiếp lên MinIO raw
↓
Backend confirm upload và tạo MediaItem
YouTube submit
Mobile gửi YouTube URL
↓
Backend tạo MediaItem chờ ingest
↓
Worker dùng yt-dlp và upload audio vào raw bucket
Hội tụ tại Backend Worker validation
Đo duration thật
Re-check quota
Enqueue ai-processing
AI Engine subtitle pipeline
chunks → batches → final
Socket + status API → Player
Key runtime idea: Hai đường input khác nhau, nhưng đều được chuẩn hóa trước khi vào GPU pipeline; từ đó artifact trung gian và final output dùng chung một contract.
Backend orchestration

Auth, quota, validation và queue không chỉ là CRUD

Auth authority

Register, verify OTP, login, refresh, logout và password reset đều tập trung ở backend.

Subscription + quota gating

Kiểm tra entitlement ở API layer, rồi kiểm tra lại bằng duration thật ở worker layer.

Presigned upload model

File media không đi qua body của NestJS; client upload thẳng vào MinIO để giảm tải path HTTP.

Worker as trust boundary

Worker chuẩn hóa local upload và YouTube ingest trước khi cho phép tiêu thụ tài nguyên AI.

Queue 1
transcription

Validation / ingest / duration / quota

Queue 2
ai-processing

ASR, NMT, artifact generation, progress events

Request gate
Raw ingest normalize
Worker re-validation
AI queue handoff
Thiết kế có chủ đích: Tách request path, worker validation và AI queue giúp hệ thống kiểm soát quota, chuẩn hóa đầu vào và không để GPU pipeline bị kích hoạt quá sớm.
AI pipeline

Pipeline thực tế đang chạy trong AI Engine

Media ingest + audio prep
→
Source inspection + Chinese prior
→
VAD + segmentation
→
ASR routing decision
English lane

Nhánh ưu tiên overlap để subtitle đi ra sớm

Đi đúng route Distil-Whisper thì transcript có thể đi sang dịch gần như ngay trong lúc ASR đang hoàn tất các phần sau.

Distil-Whisper ASR
→
during_asr overlap
→
NLLB translation
→
translated_batches sớm
Trust gate: không bật Hiệu ứng runtime: first chunk gần first batch Benchmark: 10/10 English giữ được during_asr
Chinese lane

Nhánh thận trọng hơn để bảo vệ độ tin cậy transcript

Thay vì đẩy dịch sớm bằng mọi giá, hệ thống đi qua SenseVoice Small rồi chặn ở trust gate trước khi cho artifact công khai đi tiếp.

SenseVoice Small ASR
→
Trust gate
Đúng ngữ hệ Đủ sạch để dịch Recovery nếu nghi ngờ
→
after_asr publish
→
NLLB translation
Trusted: cho batch đi tiếp Suspicious: repair hoặc refine rồi mới publish Benchmark: 10/10 Chinese bị kéo về after_asr
Artifact + realtime

Vì sao hệ thống vừa tiến dần vừa reconnect-safe

Artifact contract

Một đường dữ liệu bền vững, ba mức độ hoàn thiện

Tier 1

chunks/

Transcript checkpoints ngay sau ASR

→
Tier 2

translated_batches/

Subtitle song ngữ usable trước final

→
Tier 3

final.json

Canonical output cho replay, reopen và benchmark
Durable path

AI Engine ghi artifact theo tầng vào MinIO

AI Engine write
MinIO lưu version theo path
Backend cấp signed access khi client cần đọc lại
Realtime path

Kênh sự kiện tách riêng để màn hình processing theo dõi tiến trình

AI Engine → Redis Pub/Sub
Redis → Backend socket mirror
Backend → Mobile processing UI
Reconnect-safe story

Mất socket không làm mất trạng thái tiến dần

Nếu processing screen rớt kết nối, artifact vẫn tiếp tục được ghi. Nếu user mở lại player, app hydrate lại từ `translated_batches` hoặc `final.json`. Vì vậy realtime chỉ là lớp theo dõi, còn artifact mới là lớp sự thật lâu dài.
Product surfaces

Hệ thống không dừng ở pipeline, mà đã có bề mặt sử dụng thật

Player subtitle song ngữ
Player song ngữ là nơi artifact được tiêu thụ trực tiếp.
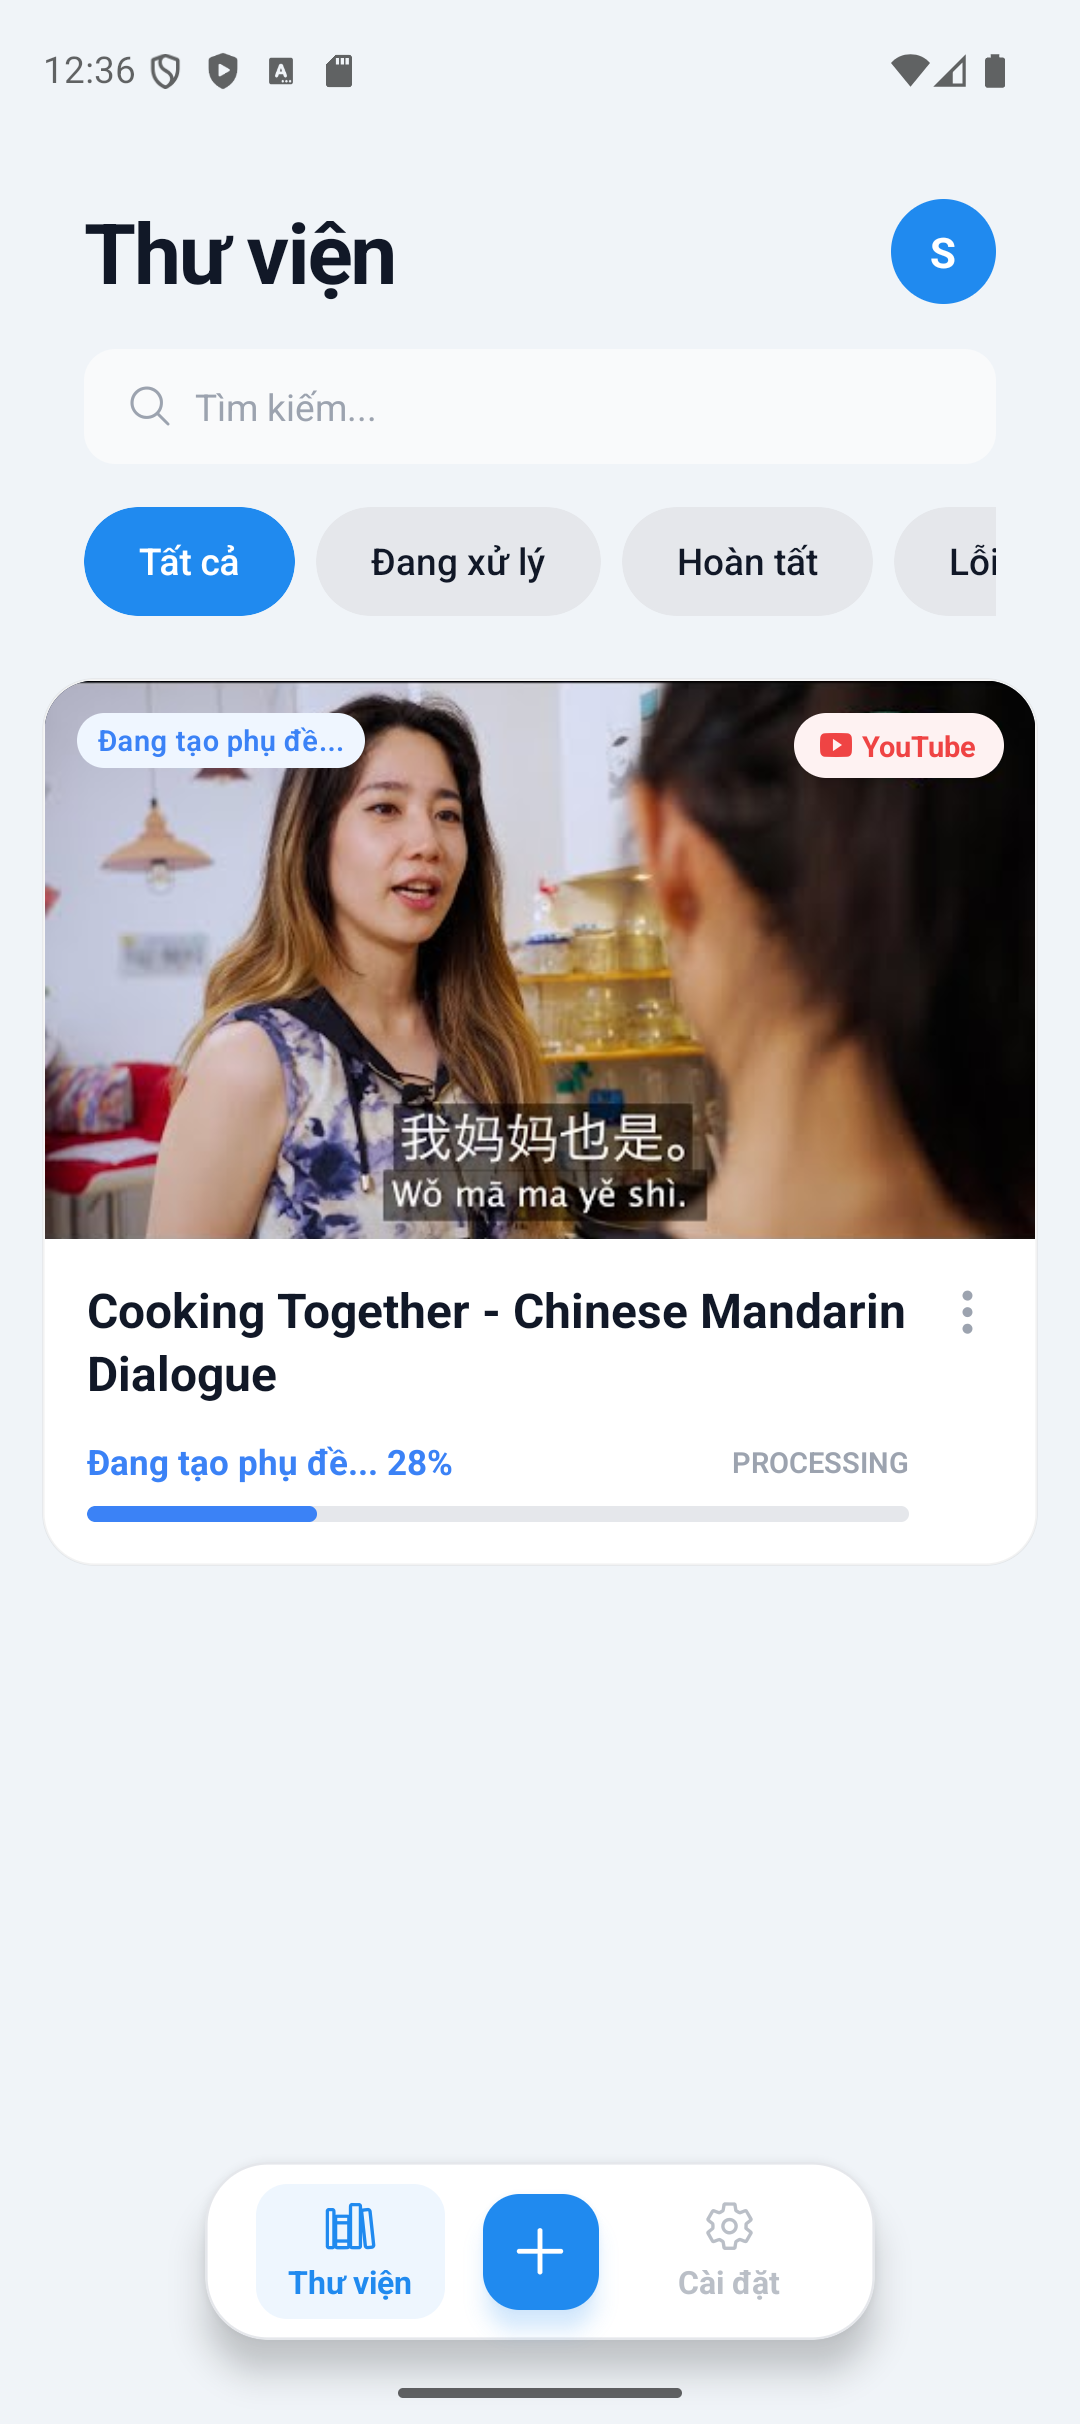
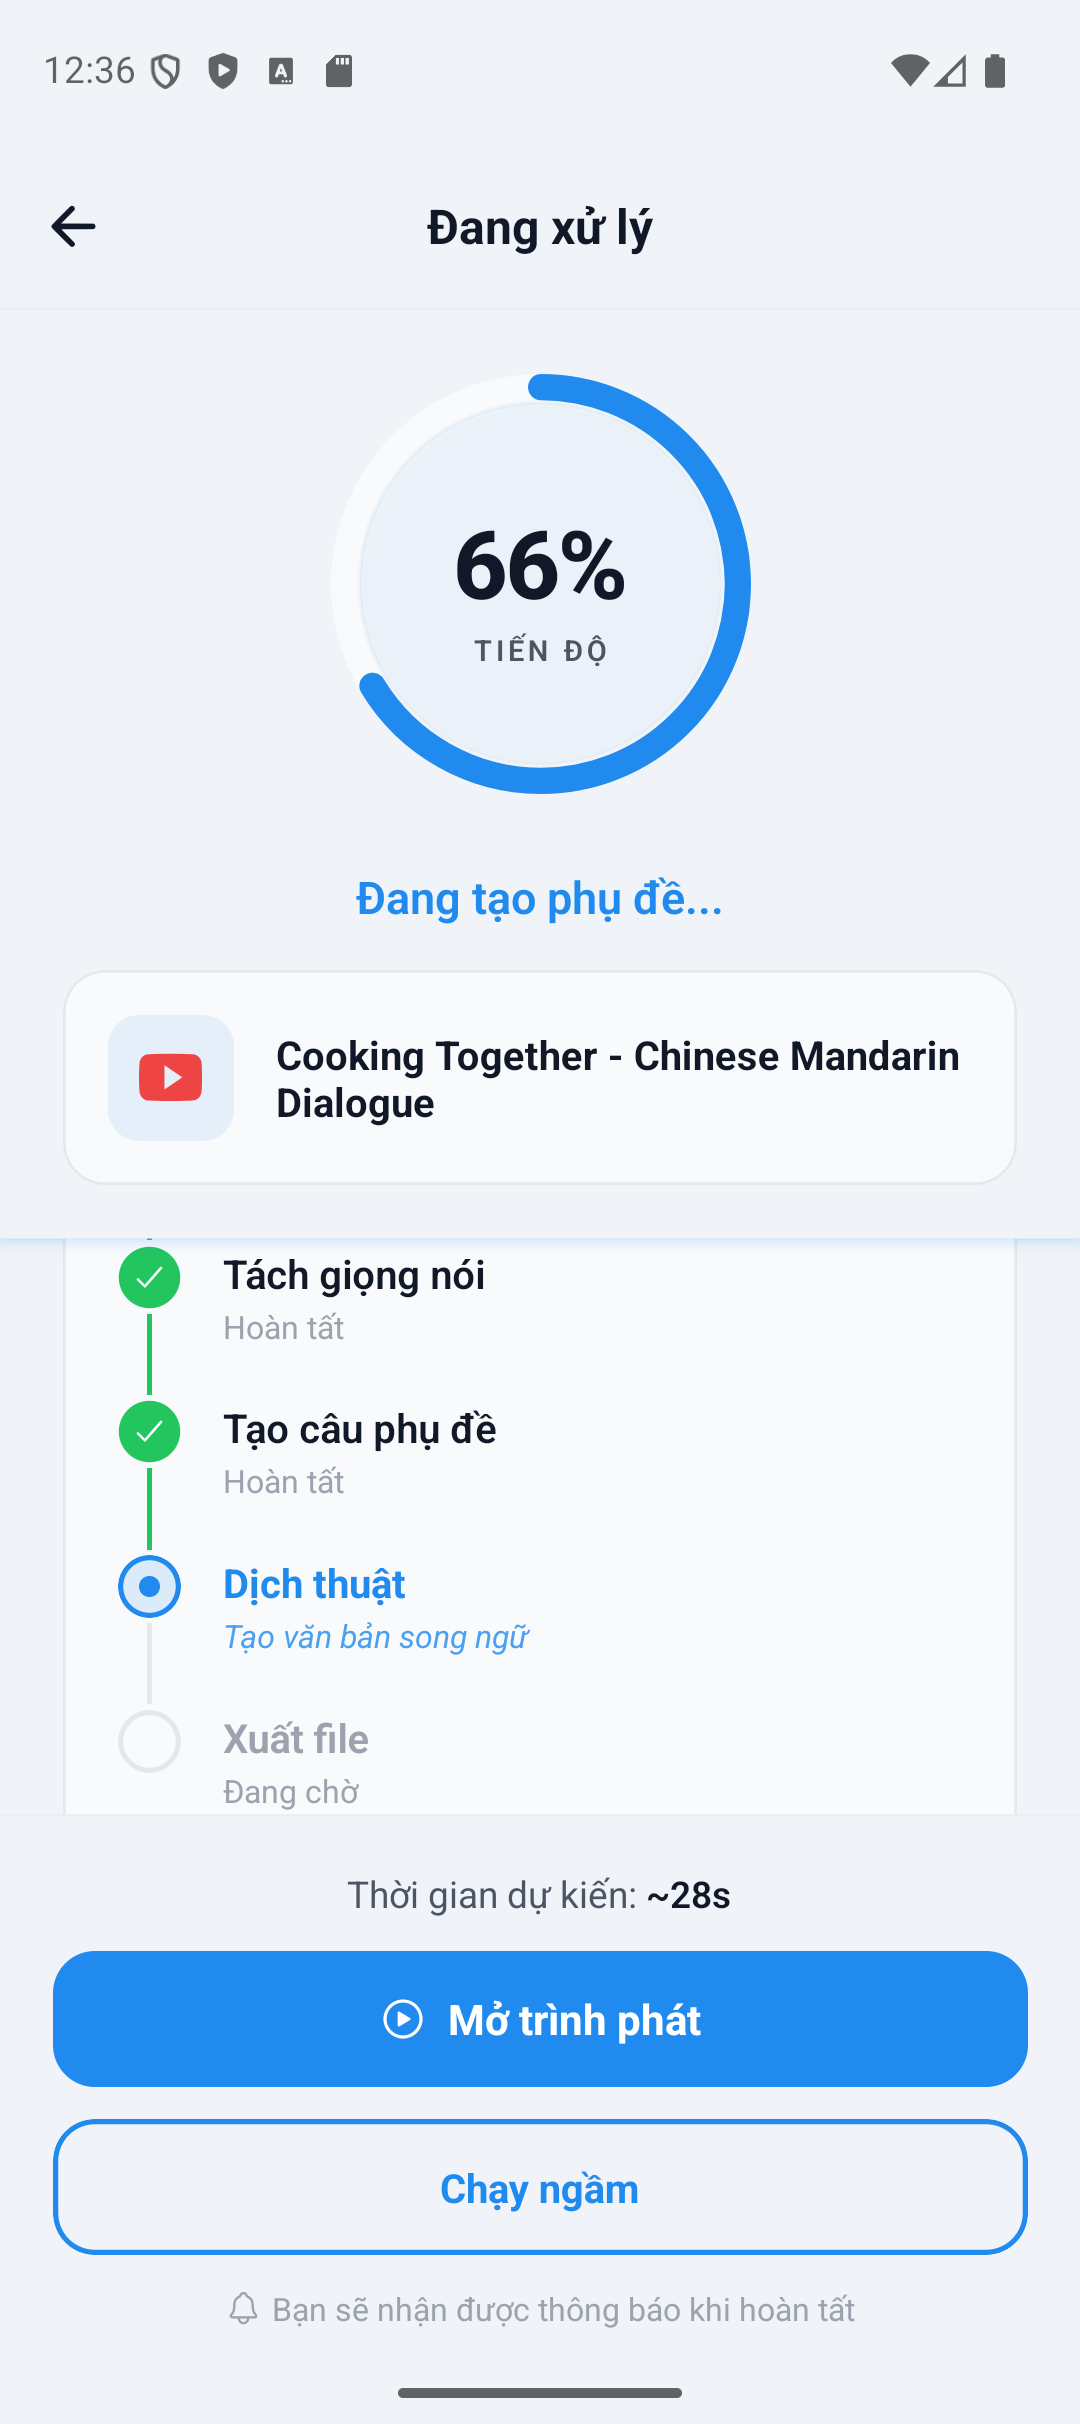
Màn hình processing
Processing screen theo dõi progress và current step.
Màn hình lookup
Lookup / Explain / word bank tạo giá trị sau khi subtitle đã sinh ra.
Thư viện media
Library giữ media và artifact để mở lại, replay và tra cứu.
Benchmark setup

Chapter 3 đo pipeline ở mức hệ thống

20 YouTube cases
10 English

Target language: tiếng Việt

10 Chinese

Target language: tiếng Việt

18 manual references

Có manual subtitle để tính WER/CER

Poll = 1000 ms

Timing theo backend polling interval

Metric groups

Latency, ratio wall-clock trên thời lượng media, first chunk, first translated batch, artifact completeness, WER/CER, policy evidence, progressive artifact evidence.

Caveat quan trọng

Toàn bộ milestone timing là polling-observed từ backend status polling, không phải timestamp socket hay client tuyệt đối.

Benchmark results

Số liệu không đứng riêng, mà phản ánh đúng runtime policy

20/20 cases completed
143.27s avg latency
0.223x avg latency ratio
18/20 progressive before final
20/20 final schema valid
Family comparison

Nhiều chỉ số cùng chỉ về cùng một kết luận: English và Chinese đang chạy hai runtime policy khác nhau.

Metric English Chinese
Avg latency 125.288s 161.251s
Avg ratio 0.193 0.253
Avg first chunk 67.714s 70.333s
Avg first batch 67.714s 84.55s
Avg WER 0.036 0.247
Avg CER 0.021 0.181

Policy evidence

English giữ `during_asr`10/10
Chinese bị kéo về `after_asr`10/10
Parsed policy metadata từ log20/20
English path: Distil-Whisper, trust gate không bật, overlap dịch sớm ổn định.
Chinese path: SenseVoice Small, trust gate bật, dịch chậm hơn để bảo vệ transcript nguồn.

Artifact quality

Empty translation0
Invalid timestamps0
Overlaps0
Manual subtitle available18/20
Pipeline ổn định và output hợp lệ, nhưng transcript Chinese vẫn là nút thắt lớn hơn English.
Avg first chunk: 69.02s
Avg first batch: 76.13s
Source: chapter3 benchmark report
Đóng góp kỹ thuật

Điểm mạnh của đồ án nằm ở tích hợp hệ thống

01

Subtitle platform end-to-end

Từ ingest media, orchestration, artifact cho đến player song ngữ.

02

Async architecture rõ ràng

Tách API, worker và AI Engine thay vì dồn toàn bộ vào một service duy nhất.

03

Artifact model tiến dần

`chunks`, `translated_batches`, `final.json` giúp hệ thống vừa usable hơn vừa benchmarkable hơn.

04

Chinese trust path có chủ đích

Không đánh đổi hoàn toàn chất lượng transcript để lấy output sớm ở những case khó.

End-to-end product system
Async architecture
Progressive artifact contract
Chinese trust-gated path
Hạn chế và định hướng

Trung thực về giới hạn, rõ ràng về hướng đi tiếp

Giới hạn hiện tại

  • Chưa nên gọi là live simultaneous interpreting.
  • Chinese path vẫn là điểm yếu lớn nhất về latency và WER/CER.
  • Timing benchmark hiện là polling-observed.
  • Translation quality đích chưa có manual review đủ sâu như transcript nguồn.

Hướng phát triển

  • Tối ưu Chinese route và trust-gated runtime policy.
  • Giảm latency của progressive subtitle pipeline.
  • Mở rộng đánh giá translation quality.
  • Hoàn thiện thêm lớp vận hành và scale của hệ thống.
Nói thẳng khi bảo vệ

Đây là đồ án phát triển ứng dụng phần mềm tích hợp Machine Learning, không phải nghiên cứu huấn luyện mô hình mới.

Điểm giữ được

Dù còn hạn chế, hệ thống đã chạy end-to-end, có benchmark, có artifact chuẩn và có bề mặt sử dụng thật.

Key takeaway: Đồ án đã chứng minh được năng lực xây dựng một hệ thống phần mềm tích hợp ML có kiến trúc rõ, pipeline chạy được, benchmark trung thực và bề mặt sử dụng thực tế.